
昨今、サイバー攻撃や不正アクセスなどセキュリティ関連のニュースも増えてきて、ローカルLLMへの意識が高まっています。
私自身も、AIエージェントをローカルで動かすことを想定しつつも、今のノートパソコンではスペックが足らないため、新しくAI専用のデスクトップパソコンを検討しています。
そんな中、デスクトップパソコンを買う前に、ローカルLLM環境の構築をテストしておくことにしました。
私が非エンジニアというのもありますが、スマートフォンのTelegramから指示を出し、パソコン内のAIエージェントに作業をしてもらうところまで構築するのは、思っていたより手間と時間がかかりました。
自分が苦労したというのもありますが、今回は、ローカルLLMのAIチームを作る全手順を記録として残すことにしました。
※2026年11月9日から15日にかけて、実際に構築して検証し、実務に使い始めた記録をもとにまとめました。つまずいた箇所と切りわけ方も含みます
作るもの|自分のパソコンの中で動くAIチーム
ChatGPTやClaude、GeminiなどのAI、Codex、Claude Code、AntiGravityなどのAIエージェントは、クラウドのAIサービスですが、今回実施するのは、クラウドAIではなくローカルAIでの仕組み構築になります。
ローカルLLMは、パソコンのスペックが高くないと満足できるAI環境にできないため、個人で導入するにはハードルが高いAI活用方法です。
ただ、今後、クラウドAIサービスに仕事の中身を渡さず、自分のパソコン内で重要な仕事を任せられる環境を作っておくことは、情報漏洩リスクを下げると同時に、ネット環境がなくてもAIを使える環境を作ることにつながります。
実際に、ローカルLLMのAIチームを作らないにしても、AIの話題が多いビジネスシーンで話のネタにもなるのでローカルLLMの話題は知っておくと便利です。
今回作るローカルLLMのチーム
- 指示を出す「司令官(AI)」と、実際に作業する「実働(AIエージェント)」の2役を置く
- 頭脳は、パソコンの中で動くローカルモデル(Ollama)
- 入口はスマホの Telegramで、外出先からも指示できる
- あなた(人間)の仕事は、判断と最終確認だけ
ローカルのAIチームを完成後は、実際にコンテンツ作りのテストを開始しています(実務に使い始めた記録)。
司令官(AI)と実働(AI)にわける理由
今回、ローカルLLM環境を整える上で、司令官(AI)を作るだけでなく、あえて実働(AI)まで作ることにした理由は、仕事を頼む相手を1役にまとめると、依頼をする人間側の都合が悪くなるからです。
司令官(AI)と実働(AI)にわける理由は2つあります。
理由1|頭脳の大きさを使いわけられる点
仕事を分解して渡す司令官(AI)には、文脈を長く保てる大きい頭脳が必要です。一方、言われた作業をする実働(AI)は、軽い頭脳でも実務をこなしてくれます。
役をわけると、重い頭脳を司令官だけに集中できます。
理由2|できあがったファイルを確かめやすい点
実働(AI)が作ったファイルは、司令官(AI)とは別の場所に置かれます。
「誰が・何を・どこに作ったか」がわかれていると、本当にできたかどうかを確かめるときに迷いません。
ローカルLLMのAIチーム完成形のイメージ
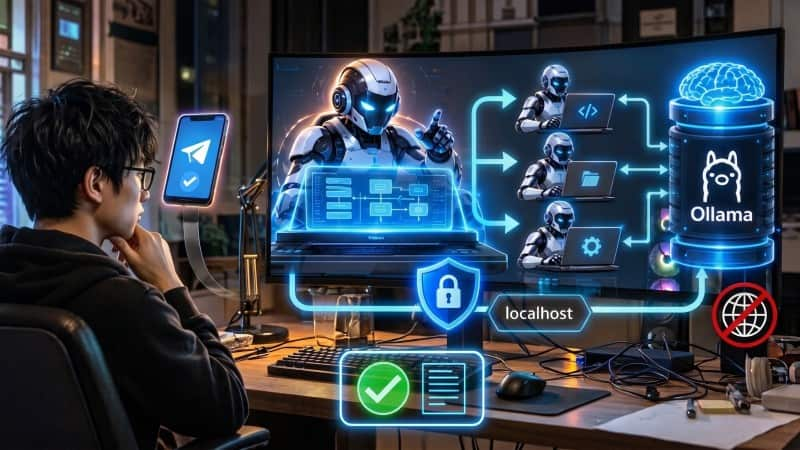
- あなた(人間)|判断と最終確認だけを行う
- 司令官(AI)|OpenClawのメインエージェント。人間の指示を受けて仕事を分解し、実働(AI)へ渡し、結果を報告する
- 実働(AI)|OpenClaw のコーディングエージェント。ファイル作成などの実際の作業をする
- 頭脳(Ollama のローカルモデル)|司令官=大きいモデル(qwen2.5:32b、約19GB)、実働=軽いモデル(llama3.1:latest)
- 入口|スマホの Telegram(専用ボット経由)。承認した本人だけが話せる
- 鉄則|通信は全部このパソコンの中(localhost)だけ。外部に出るのは Telegram との通信のみ。
※完全に外部と遮断したい場合は、Telegramを使わずにパソコン内だけで完結するのが望ましい
成功の測り方は処理時間ではなく、人間の拘束時間です。人間は極力作業をせず、指示と最終確認だけに時間を使う形を目指します。
localhostは「自分のパソコン自身」を指す呼び名です。
司令官の受け付けも、頭脳の置き場所も、localhost(パソコン内)でだけ待ち受けます。localhostで待ち受ける限り、外のパソコンからは中に入れません。
家の内側からしか開かない扉、という状態です。構築の間、localhostの作りを崩さない点が安全の土台になります。
ローカルAIチームが向いている人・向いていない人
普通に使うだけなら、無料版のクラウドAI(ChatGPTやGemini、Copilotなど)で十分満足できます。ほとんどの人は、クラウドAIの有料契約やローカルLLMの構築は不要です。
ただ、ここまで読んでいるあなたは、クラウドAI有料契約の価格を抑えたいか、毎月の有料契約をやめたいと思いますので、クラウドAIがいいのか、ローカルLLMを構築するほうがいいのかを見極めていきましょう。
向いている人
- 自分のパソコンの中でAIを動かしたい人
- 仕事の中身をクラウドに出したくない人
- クラウドAIでは使用上限になってしまう人
- コマンドを打つ画面での設定作業が苦にならない人
ちょっとAIとチャットを使うのではなく、AIエージェントで仕事をガンガン回すあなた向けです。
トークン使用料がボトルネックになります。単純作業はローカルLLMで回し、難易度の高い部分だけをクラウドAIやAIエージェントで処理をするような使いわけを考えるレベルで使うなら、ローカルLLMを使えるスペックのパソコンを検討しましょう。
向いていない人
- 今すぐ速い応答が必要な人
- パソコンの設定を一切触りたくない人
ローカルLLMのAIチームは構築するのに、かなり根気がいります。パソコンの専門知識がなくてもAIチームは構築できますが、一回ですんなり導入できるほど簡単ではありません。
あと、かなりハイスペックのパソコンを使わないと、ローカル環境でストレスなくAIを使えないので、パソコンにお金をかけられる人じゃないと向かないと思っておきましょう。
ローカルLLMの場合、速さはパソコンの性能で決まります。私がテストをしたノートPCの環境では、返事に10分以上かかるのも普通です。
今回ローカルLLMのAIチームを構築してテストをした環境
- Windowsノートパソコン(速いメモリ=グラフィック用(GPU)4GB/通常のメモリ 64GB/保存容量 3TB)
- 頭脳のモデル(約19GB)は速いメモリに入りきらないため、処理の大部分は遅い側で回ります。速くない環境でも「動く形」まで持っていけた記録です。
- 構築時の記録|OpenClaw 2026.11.2/Ollama 0.40.15→0.40.16/PowerShell 5.1/Python 3.12。Mac でも流れは同じで、設定ファイルの置き場所も ~/.openclaw/ で共通です。
実際に24時間体制で回すデスクトップPCではなく、テスト用に使用したノートパソコンは、ドスパラのレイトレックを使用しました。GPUは標準のままNVIDIAのGEFORCE RTXの4GB、カスタムしている内容は、メモリ64GB、保存容量を3TBです。
もともとゲームをしないことと、ローカルLLMで使う予定のパソコンではないため、GPUのスペックが全く足らないもののテストレベルでは動作確認することができました。
メモリの見方
パソコンには2種類のメモリがあります。
通常のメモリ(RAM)と、グラフィック用の速いメモリ(GPU)です。頭脳のモデルは、速いメモリに入る分だけ速く動きます。
構築した私のPC環境では、通常のメモリは64GBと余裕がありますが、速いメモリ(GPU)は4GBしかありません。
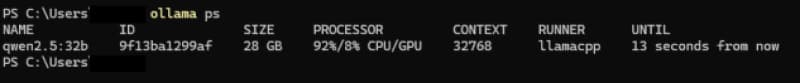
約19GBのモデルは速いメモリ(GPU)に入りきらず、処理の92%が遅い側(CPUと通常のメモリ)で回りました。
「メモリは足りているのに遅い」と感じる場合、足りていないのは通常のメモリではなく速いメモリ、という場面が多いです。
パソコン選びでは、通常のメモリの大きさと速いメモリの大きさをわけて見てください。
※バランスの良い振りわけは、メモリ32GB、GPU32GBのようなイメージです
手順通り進めるときのポイント
手順1~6までがローカルLLMのAIチーム構築の手順です。
順番どおりに進めてください。手順4の確認テストに合格するまで、手順5へは進まないでください。
受け渡しが成立していない状態で入口(Telegram)をつないでも、指示が仕事になりません。
途中で止まったら、つまずき集で症状から解決策を探してみてください。「軽量化の記録」と「実務に使い始めた記録」は、構築が終わった後の調整と運用の記録です。
ローカルLLMでAIチームを作るときに用意するもの
ローカルLLMでAIチームを構築するときに用意するものは次の3つです。
パソコン
メモリは大きいほど安心です。AIの処理に必要なデータがメモリに収まりきるかどうかで、動作速度が変わります。
Node.js
OpenClawが求めるバージョンを用意してください。構築時は25.8.2だとバージョンが合わず、26.13.0を使用しました。
スマホ
Telegramを利用するために使います。人間側からパソコン上のAIへ指示を出す窓口として活用します。
OpenClaw は Node.js の版に指定があります。
構築時に指定されていた範囲は「24.16以上・25未満、または26.1以上」でした。私のPC内にあった 25.8.2 は範囲から外れていて、版の不一致で進めませんでした。
Windowsのwingetという仕組みで、Node.jsのLTS版を入れ直して、26.13.0 にすると、同じ手順で通ります。
Node.js の入手先は公式サイト(https://nodejs.org)です。
「手順どおりなのに最初の段階で止まる」場合、疑う場所はパソコンの故障ではなく、土台のNode.jsの版の不一致です。
エラーの文面に版の数字が出ていたら、数字を合わせてから入れ直してください。
手順1|Ollama(頭脳の土台)を入れる
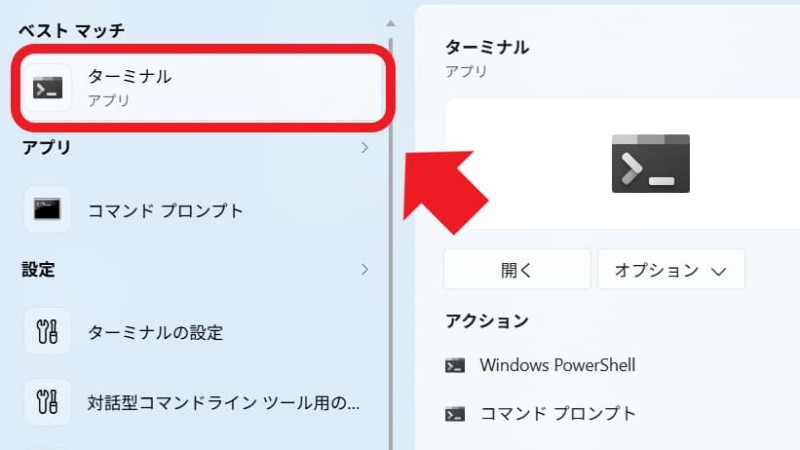
まず、コマンドを打つ画面(ターミナルもしくはPowerShell)を開きます。
※今回はターミナルで進めますので以後ターミナルで統一します
Windowsキーを押して「ターミナル」と打って、Enterを押します。コマンドを打つ画面が開きます。
Ollamaを公式サイト(https://ollama.com/download)からダウンロードして、インストールします。起動すると、画面の右下(タスクトレイ)/メニューバーに小さいアイコンが出て常駐する形になります。
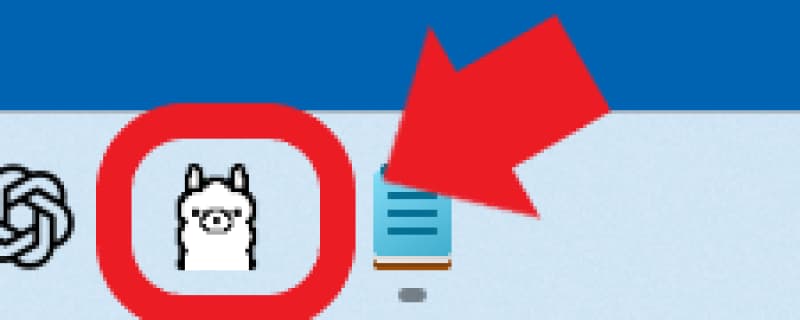
パソコンを再起動した直後は、Ollama がまだ起動していないことがあります。
アイコンが出ていない時は、画面左下から「Ollama」を開いて、アイコンが出るまで待ちましょう。
再起動のたびにこうなる場合は、設定 → アプリ → スタートアップで「ollama.exe」をオンにしておくと、再起動のあとも自動で起動するようになります(2026-11-18に実機でテスト。くわしくは、つまずき集の「再起動のあと、接続できないエラーが繰り返し出る」を見てください)。
手順1-1|コマンドを打つ画面(ターミナル)
モデルを取り込むために、次のコマンドを打ちます。
ollama pull qwen2.5:32b
ollama pull llama3.1:latest
手順1-2|コマンドを打つ画面(ターミナル)
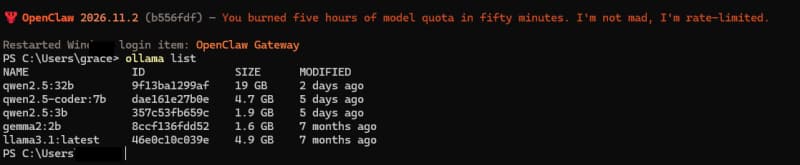
確認してから、次のコマンドを打ちます。
ollama list一覧に2つ出ればOKです。
Ollamaは初期設定でlocalhost(127.0.0.1)だけにしてください。環境変数OLLAMA_HOSTを0.0.0.0にしてしまうと外に公開されるので注意してください。
pullの所要時間と、listの見方
qwen2.5:32bは、約19GBのダウンロードです。
回線の速さによっては、インストールに長い時間がかかります。進み具合の表示が止まって見える時間帯もありますが、回線が切れていなければ進んでいるので安心してください。
失敗が繰り返される場合は、モデルの問題ではなく通信の通り道の問題を疑ってください(つまずき集参照)。
ollama listの一覧では、モデルの名前と大きさが出ます。
「qwen2.5:32b」が約19GB、「llama3.1:latest」が約5GBと出ていれば、インストールは完了しています。一覧に出ないモデルは、司令官(AI)や実働(AIエージェント)に割り当てても動きません。
割り当ての前に、必ずollama listでインストールできていることを確認してください。
OLLAMA_HOSTの注意の意味
OLLAMA_HOSTは、Ollamaが「どこからの接続を許可するか」を決める設定です。
初期設定の127.0.0.1はlocalhostの数字表記で、自分のパソコンからの接続だけを許可します。0.0.0.0 に変えると、全ての接続を許可することになり、同じネットワークにいる他の機械からAIモデルを呼び出せる状態になります。速くするための設定ではありませんので、触らないでください。
手順2|OpenClaw(司令官の体)を入れる
手順2は、OpenClawを入れます。
手順2-1|コマンドを打つ画面(ターミナル)
Node.jsを要求版に合わせてから、npmでOpenClawを入れます。次の行を打ってEnterを押してください。
npm install -g openclaw@latestNode.jsの版が合っていないと、ここで版の不一致のエラーが出て止まります。私が構築するときは25.8.2で止まり、次の行を打ってNode.jsを入れ直すと26.13.0になりました。
winget install OpenJS.NodeJS.LTS入れ直した後は、もう一度「npm install -g openclaw@latest」を打ちます。
入れる途中で 4つの後処理が止められた場合は、次の行を打ってください(–allow-scripts の部分は、その4つだけの1回かぎりの許可です)。
npm install -g openclaw@latest --allow-scripts=@google/genai,esbuild,protobufjs,openclaw入ったかどうかは、同じ画面で「openclaw –version」と打つと確認できます。構築時は2026.11.2と表示されることを確認しました。
手順2-2|コマンドを打つ画面(ターミナル)
次の行を打って「Enter」を押すと、初期設定が始まります。
openclaw onboard --install-daemon【パソコンの画面】初期設定(QuickStart)の選択は次のようにしました。【パソコンの画面】
初期設定(QuickStart)の選択は次の通り
- エージェント名: main
- 頭脳の相手: Ollama
- 接続範囲: Local only
- 接続先アドレス: http://127.0.0.1:11434
- 受け付け係(Gateway): 127.0.0.1 で待ち受け、ログイン時に自動起動する形で登録
- Tailscale: オフ
- チャンネル接続: この時点では全部スキップ
手順2-3|コマンドを打つ画面(ターミナル)
次のコマンドでチャット画面を開きます。
openclaw tuiと打つとチャット画面が開きます(openclaw だけ打っても開きます)。
OpenClawはアプリではなく、コマンドを打つ画面(ターミナル)から開く画面になるので、アプリをインストールしないよう注意してください。
ターミナルでコマンドを送る前に、Ollamaが起動し終わっていることを確認しましょう。
パソコンの起動直後はOllamaがまだ起動しておらず、送っても「AIサービスに接続できない」エラーになることがあります。
手順2-4|チャット画面(OpenClaw)
チャット画面に何か一言文章を送り、AI(司令官)が文章を返してくれれば土台は完成です。
Gateway(受付係)の役割
Gatewayは、AI(司令官)への入口を管理する常駐の受付係です。
チャット画面やTelegramからの指示は、全部 Gateway を通ってAI(司令官)に届きます。Gateway が止まっていると、頭脳が動いていても指示は届きません。
「返事が来ない」時の確認は、Gatewayが動いているか → 頭脳(Ollama)が動いているか、の順です。
ログイン時に自動起動する理由
Gatewayをログイン時の自動起動にしておくと、パソコンを再起動しても、ログインすれば司令官が受け付けを再開します。
自動起動にしていない場合、再起動のたびに手作業でGatewayを起動し直す必要があります。Telegram からいつでも指示できる形は、自動起動が前提です。
手順3|コーディングAIエージェント(実働)を足して受け渡しを許可する
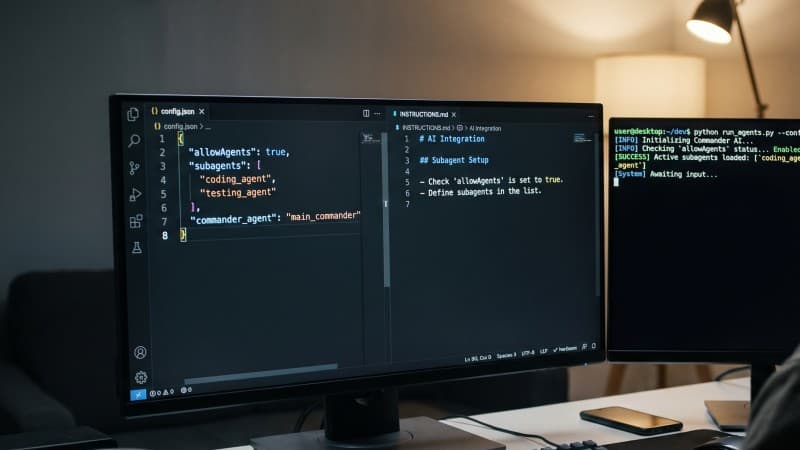
次に、AI(司令官)から指示を受けて、実際の作業を行うコーディングAIエージェントを作り、AI(司令官)からコーディングAIエージェントに仕事を受け渡しできるように設定します。
手順3-1|コマンドを打つ画面(ターミナル)
実際にパソコン内で作業をするAIエージェント(実働)を追加するために次のコマンドを打ちます。
openclaw agents add coder --model ollama/qwen2.5-coder:7b --workspace $env:USERPROFILE.openclaw\workspace-coder --non-interactive登録の時に指定する頭脳(–model の後ろ)は、この後の「頭脳の割り当て」で「ollama/llama3.1:latest」に書き換え、作業場所はわけます。
- AI(司令官)|~/.openclaw/workspace
- AIエージェント(実働)| ~/.openclaw/workspace-coder
手順3-2|パソコンの画面
受け渡しの許可リストを書き入れます。
設定ファイル「~/.openclaw/openclaw.json」をメモ帳で開き、司令官(main)の欄(”name”: “main” の下)に、次の1行を書き入れて上書き保存します。
許可リストがないと、AI(司令官)はAIエージェント(実働|コーディングエージェント)を呼べません。
"subagents": { "allowAgents": ["coder"]}次に頭脳の割り当てを行います。
手順3-3|パソコンの画面
設定ファイル「~/.openclaw/openclaw.json」をメモ帳で開き、次の2か所を書き換えます。
書き換える前に、設定ファイルのバックアップを取りましょう(バックアップの取り方は、この後の「設定を変える前の決まり」を確認ください)。
- 司令官(main)|司令官の欄にある “primary” の値を “ollama/qwen2.5:32b” に書き換えます
- 実働(coder)| 実働の欄にあるモデル指定を “ollama/llama3.1:latest” に書き換えます
メモ帳で記載している場所を探す時は、行の番号は、書き入れる行が増えるとすぐずれるため、行の番号ではなく “primary” などの文字で探してください。
ファイルの下のほうにあるモデル定義の行は触らないようにしましょう。変えるのは、この2か所だけにしてください。
手順3-4|コマンドを打つ画面(ターミナル)
変更したら「openclaw gateway restart」して、「openclaw agents list」で割り当てを確認します。
パソコンの画面でマークダウンファイル(.md)に追記
AI(司令官)への指示書(~/.openclaw/workspace/AGENTS.md)を開いて(右クリックからメモ帳で編集)、役割と受け渡しの決まりを書きます。私が記載した要点は次の通り。
日本語で応答する司令官であること成果物を作る仕事は、AIエージェント(実働)へ渡し、完了の報告は「ファイルが実在するか確認してから」行うようにしてください。ファイルが実在しない場合は「未確認」と伝えてください。
AI(司令官)との会話と、受け渡しの切りわけは、私が試行錯誤して追加した決まりで、そのまま使える文面にしています。
AI(司令官)との会話と受け渡しの切りわけ(優先)
- 会話で完結するものはAI(司令官)が直接答え、AIエージェント(実働)に渡さない
- AIエージェント(実働)へ渡すのは、ファイル作成やコード作成などの成果物を作る仕事だけ
- AIがAIエージェントに仕事を受け渡したときは、報告に「何を頼んだか」を1行で具体的に書く
- AIとAIエージェントの役割の切りわけは、他の受け渡しの決まりより優先する
パソコン内のAIの窓口(司令官)の役割、AIの窓口(司令官)の下で働くコーディングAIエージェント(実働)の役割を決め、AIとAIエージェントの仕事の切りわけを決めていきます。
設定を変える前の決まり
必ず設定ファイルの控えを取ってください。
名前は「openclaw.json.pre-<変更内容>.bak(例: openclaw.json.pre-qwen32b.bak)」。変更は1回に1か所だけにして、再起動して確認します。
なお、⼿順3の時点の「AI(司令官)への指⽰書(.md)」は、スペック不足のパソコンでうまく仕事を受け渡しできなかったため、後で⼤きく軽くしました(軽量化の記録)。
最初から「AI(司令官)への指示書(.md)」作る場合は、軽量化の記録の「役割カード」の形を⼟台にするのがおすすめです。
作業場所をわける理由
パソコンの窓口のAI(司令官)は、自分の作業場所にある記録を毎回の文脈として読み込みます。
実働の成果物や作業途中のファイルが司令官の作業場所に混ざると、読み込む量が増えて、返事が遅くなり、最後には返事が返らなくなります。
実際に、昔の作業記録が溜まった点が軽量化のボトルネックになりました。作業場所の分離は、整理のためではなく、司令官の読み込み量を守るための分離です。
許可リストがない時の症状
許可リストを設定していない状態では、AI(司令官)はコーディングAIエージェント(実働)を呼べません。
困る点は、失敗の出方です。司令官が「実働へ渡しました」と報告しても、実際には受け渡しが起きていない場面があります。
報告と実態が食い違うので、人間は手順4の確認テスト(実ファイルで確かめる手順)でしか異常に気づけません。受け渡しの仕事を始める前に、許可リストの有無を必ず確認してください。
控えの名前に変更内容を入れる理由
設定ファイルのバックアップは、「openclaw.json.pre-qwen32b.bak」のように「何を変える前の控えか」が名前でわかる形にします。
控えが増えた時に、戻したい時点の控えを名前だけで選べます。日付だけの名前では、複数の控えの区別がつかないので、自分がわかるファイル名にしておいてください。
手順4|受け渡しの確認テスト(合格するまで先へ進まない)
では、作業に戻りましょう。手順4は、AIへの仕事の受け渡しの確認テストです。
手順4-1|コマンドを打つ画面(ターミナル)
openclaw tui と打って、チャット画面を開きます。
手順4-2|チャット画面(OpenClaw)
/newと送ってチャットを新しい会話にしてから、AI(司令官)に、普通の文章で仕事を1つだけ頼んで、ファイルを作成してくれるかをテストします。
coderに頼んで、workspace-coderにnatural-test-YYYY-MM-DD.txtを作らせて。内容は「自然な指示での受け渡しテスト YYYY-MM-DD」だけにして。実際に、ファイルが作成されたかの確認は、必ず人間が目視で行うようにしてください。AI(司令官)の「作りました」という報告は証拠になりません。
AI(司令官)に仕事を頼むときは、ツールの名前や専門的な言い方を使わず、わかりやすくミスをしにくい頼み方を心がけましょう。
私の場合、最初軽いAIモデルを使っていた際に、AI(司令官)から「作りました」と何度も報告を受けたものの、ファイルは作成されていませんでしたので、複雑な仕事を頼む場合は、AIモデル選びも重要です。
手順4-3|コマンドを打つ画面(ターミナル)
次のコマンドで、ファイルが作成されたかを確認できます。
dir ~.openclaw\workspace-coder
Get-Content ~.openclaw\workspace-coder\natural-test-YYYY-MM-DD.txtファイルがあり、中身が指定通りなら合格です。
画面表示が文字化けする時は、ファイルのバイト数と指定文のバイト数が合うかで判定できます(日本語1文字3バイト計算)。
普通の文章で頼む理由
確認テストで、作業を実行する機能(英語ではツールと呼ばれます)の名前や専門の言い方を指定すると、AI(司令官)は指定されたツールの使い方だけを試す形になります。
テストを完了した後、あなたが実際に本番の仕事に入るとき、チャット画面で普通の文章(音声入力含む)で仕事を頼むはずです。
普通の文章で頼んで受け渡しが成立する状態でなければ、本番でも仕事の受け渡しは成立しません。確認テストは、本番と同じ頼み方で試すことに意味があります。
バイト数照合の具体例
2026年11月13日に、実際に私がテストをした合格時の実例です。
指定した文は「自然な指示での受け渡しテスト 2026-11-13」で、ファイルの大きさは 53バイトでした。
日本語の部分「自然な指示での受け渡しテスト」は14文字。日本語1文字は3バイト計算で、14文字 × 3 = 42バイト、半角の空白が1バイト、日付「2026-11-13」が10バイト、合計 42 + 1 + 10 = 53バイトです。
画面の文字化けで中身が読めなくても、バイト数が指定と一致すれば、中身が指定どおりに入っている判定ができます。
ファイルが生成されず合格判定できない時に見る場所
ファイルがない場合、見る順番は次の3つです。
- 許可リスト(手順3)が入っているか
- AI(司令官)の頭脳が、作業を実行する機能の呼び出しに対応したモデルか
※つまずき集。文章で呼び出しを返すモデルでは受け渡しが成立しません - 司令官の頭脳の大きさが足りているか
※小さいモデルは、短いやり取りでは受け渡しできても、本番の文脈の長さでは崩れます
手順5|Telegram(テレグラム)をつなぐ
OpenClawのテストを完了したら、いよいよ、Telegramとの連携です。
Telegramと連携することで、外出中でも、スマホのTelegramのチャット画面で仕事を依頼すると、自宅のパソコンに常駐しているAI(司令官)やAIエージェント(実働)が仕事をして、スマホのTelegramで仕事の進捗を報告してくれるようになります。
手順5-1|スマホ側
先にスマホ側の設定をします。Telegramアプリを入れましょう。
Telegramに登録する名前は本名じゃなくて大丈夫です。
権限の確認がいくつか出るが、「電話の発信と管理」「通話履歴」は許可しなくてOKです。AI(司令官)からの返事に気づけないため、通知だけは許可するようにしてください。
TelegramのAndroid版は、言語の一覧に日本語が出ないことがあります。日本語が出ない場合は、スマホのブラウザで公式の日本語言語パックを開いて適用してください。
「https://t.me/setlanguage/ja-beta」を開くと、アプリが開いて適用の確認が出るので、「Change」を押して変更してください。
Telegram で公式の @BotFather(青いチェック付き)を開いて、下記の内容を進めます。
- /newbotと送る
- 表示名を決める(例: ぶらっく司令官)
- ユーザー名を決める(半角英数字、最後が bot で終わるもの)
- 合言葉(トークン)が表示される。合言葉がボットの鍵になる。
表示名とユーザー名の違い
表示名は、人間が見る名前です。後から変えられます。
ユーザー名は、ボットの住所にあたる名前で、最後が bot で終わる形にします。合言葉の入力や接続の確認で使うのはユーザー名です。2つを混同すると、探す場所を間違えるので注意してください。
合言葉の扱い(最重要)
合言葉はパスワードと同じです。AIとともに設定を進めている場合でも、合言葉を共有しないように注意してください。
合言葉をチャットや画面写真で共有しないようにしてください。
もし、合言葉が写ってしまったら、BotFatherで「/revoke」を使って即座に作り直しましょう。「/revoke」を使うと、古いものを無効にできます。
実際、今回の構築では私は2回作り直しました。
パソコンへ移すものは、合言葉(トークン)の文字列そのものです。
移し方はコピーと貼り付けです。
パソコンのブラウザで Telegram ウェブ版(web.telegram.org)にログインし、BotFather との会話に表示された合言葉の「Copy」から直接コピーして、パソコン側の入力欄(5-2 の「合言葉の入力待ち」の画面)に貼り付けます。
ボット自体や会話の中身は移しません。移るのは、この文字列だけです。
合言葉のコピーは、必ず最後にしてください。
パソコンはコピーを1つしか覚えられません。合言葉をコピーした後に別の文字列をコピーすると、合言葉は上書きされて消えます。手順は3つです。
(1)先にパソコン側の作業を進めて、「合言葉の入力待ち」の画面を出しておきます。
(2)Telegram ウェブ版で BotFather に/revokeを送って合言葉を作り直し、新しい合言葉の「Copy」を押します。
(3)ほかの文字列をコピーしないまま、パソコン側の入力欄に貼り付けてEnterを押します。
実際に、私は合言葉を先にコピーしてから設定のコマンドをコピーして、合言葉が消えてしまったことがあります。
今回、Telegramとパソコンの設定を構築中、合言葉は2回作り直しました。
理由は、作業中の画面写真に合言葉が写り込んだことと、コピーの順番を間違えて合言葉をコマンドとして実行してしまったからです。
合言葉が外に出た可能性がある時点で、合言葉は漏れたものとして扱います。
作り直し(/revoke)は数分で終わります。「大丈夫だろう」で使い続けずに、失敗した時点でやり直すようにしてください。
手順5-2|パソコン側
次にパソコン側の設定を進めます。
コマンドを打つ画面で実行します。
openclaw channels add注意: この版(2026.11.2)では、openclaw channels add –channel telegram –token <合言葉> の書き方はエラーになりました。ヘルプの使用例には載っていましたが、実際には受け付けない状態です。案内形式を使うことで解消できるので試してみてください。
- 「Set up a chat channel now?」→Yes
- チャンネル一覧→Telegram (Bot API)
- Telegram account →default (primary)
- 合言葉の渡し方 →Enter Telegram bot token(設定ファイルに直接保存)
- 合言葉の入力欄が出たら、手順5-1の順番でコピーして貼り付け、Enter
- チャンネル選択に戻ったら、一番下の Finished
- 「Configure DM access policies now?」→No(初期設定の pairing が狙い通り)
- 「Set up administration from your own chat account?」→Skip for now(承認の時に自動で登録される)
- 「Name these channel accounts now?」→No
- 「Route these channel accounts to agents now?」→Yes→main (default)
- 「Channels updated.」と出れば登録完了。
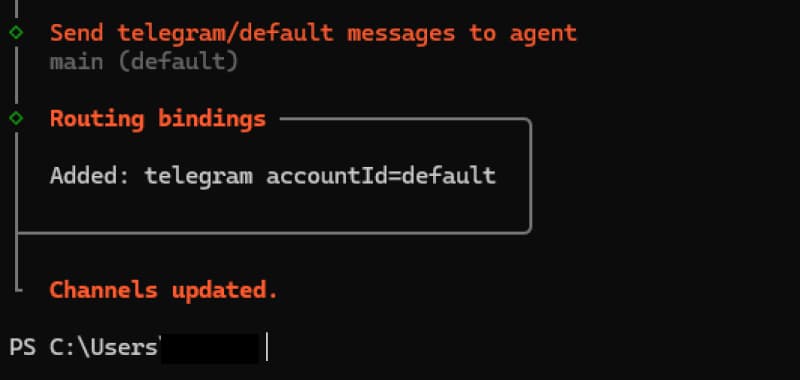
openclaw channels status「Telegram default: enabled, configured, running, connected」と出ればOKです。
スマホでボットに一文送ると、承認の番号が返ってきます。パソコン側で承認して設定を進めます。
openclaw pairing approve telegram <番号>- 承認が済むと、送った本人だけが話せるようになる※知らない人は番号で止まりで中に入れない
- 承認のついでに、本人は管理者(command owner)としても自動で登録される
設定は一度きりです。次回からは、パソコンの電源が入っていてログインした状態なら、Telegram からそのまま指示できます。
pairing(承認)の仕組み
pairing(承認)は、ボットに話しかけてきた人を、番号で1人ずつ承認する仕組みです。
ボットのユーザー名を知っている人は、ボットに文を送るところまではできてしまいます。ただし、承認されていない人の文は、承認の番号が返るだけで、AI(司令官)には届きません。
あなた(持ち主)が番号を承認した相手だけが、司令官と話せる状態になります。入口をTelegramひとつに絞って入口に承認を置く形が、ローカルの作りの安全を保ちます。
手順6|制限時間を延ばす(大きいAIモデルを動かす場合は必須)
Telegramのボットから入力中のまま返事が返ってこない際は、制限時間を延ばすことで解決することができます。
症状
Telegram でボットが「入力中」のまま、返事が何十分経っても返ってきません。
切りわけ
まず記録(ログ)を見ます。
openclaw channels logsチェックするのは2点です。
- Inbound messageの行があるか
- reason=timeoutの行が繰り返し出ていないか
ログの行の意味は、次の通りです。
- Inbound messageの行=指示が Gateway から司令官に届いた記録です。この行がない場合、届いていない場所はTelegramとGatewayの間です。
- Inbound messageの行があるのに返事がない場合、詰まっている場所は司令官と頭脳の間です。
- reason=timeoutの行 = 頭脳への試行が制限時間を超えて、やり直しになった記録です。やり直しになっている行が繰り返し出ている場合、頭脳が落ちているのではありません。制限時間が短すぎるだけです。
原因と対処
自分のパソコンで動かすAI(頭脳)には、初期設定で300秒の制限時間があります。
私が作った指示書の場合、司令官が毎回読み込む指示書と会話の量は約3万字相当あり、速いメモリに入りきらない機械では、読み込みだけで300秒を超えていました。
制限時間は「頭脳の相手(プロバイダ)」ごとに延ばすことで対処することができます。
設定ファイルの控えを取ってから、
openclaw config set models.providers.ollama.timeoutSeconds 1800
openclaw config get models.providers.ollama.timeoutSeconds
openclaw gateway restartgetで1800と出るのを確認してから再起動してください。今回の実測では、制限時間を延ばしたことで、約30分かかって返事が返ってくるようになりました(制限いっぱいまで使いました)。
1800秒に決めた根拠
1800秒は、適当に大きくした数字ではありません。
300秒では読み込みの途中で切れることがログでわかっていたので、上限を30分(1800秒)まで広げて、実測で「制限いっぱいまで使って返事が返ってくる」状態を確認しました。
制限時間を広げる作業は、速くする作業ではありません。
切れずに最後まで処理できる状態にする作業です。広げても返事が返ってこない場合は、制限時間ではなく読み込み量の問題に進みます(軽量化の記録)。
速さの正直なところ
遅さの主な原因は「毎回の読み込み量×頭脳の置き場所」です。
頭脳(約19GB)がGPU(速いメモリ)に全部入るパソコン(大容量の統合メモリを持つMac Studio ultra級)なら、今日30分かかった返事が2〜5分ほどになる見立てです。
少しハイスペックぐらいのパソコンのままで速くするなら、読み込み量そのものを減らすのが先です(軽量化の記録)。
読み込み量を減らしても足りなければ、受け答え用に軽い頭脳を用意する「役割分担」が次の調整になります(頭の良さとの兼ね合いはあります)。
会話の往復を重ねず、やってほしいことを1通にまとめて出し、裏で進めさせて、終わったら報告を受ける形が合っています。
軽量化の記録|読み込みを軽くして、質問に直接答えられるようにするまで(2026年11月15日の記録)
2026年11月15日時点、制限時間を延ばしても、AI(司令官)は質問に直接答えられませんでした。
私から投げたあいさつや質問まで、AI(司令官)が回答せずに、コーディングAIエージェント(実働)へ渡そうとしたり、接続できない失敗が起きたりしました。
原因は「毎回の読み込み量」でした。「軽量化の記録」では、重さをはかって軽くした全記録をまとめておきます。
Telegramのチャットに、待てど暮らせどAIから返事が返ってこない場合は、試してみてください。
改善1|ファイルのデータ量を確認する(重さをはかる)
AI(司令官)への指示書(AGENTS.md)のファイル容量を勝手に軽いと決めつけずに、AI(司令官)の作業場所で大きいファイルを調べます。
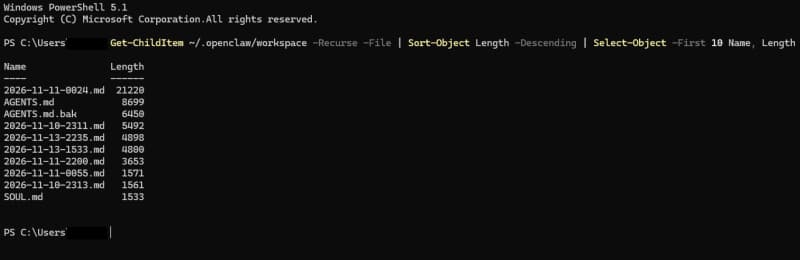
Get-ChildItem ~/.openclaw/workspace -Recurse -File | Sort-Object Length -Descending | Select-Object -First 10 Name, Length実測の結果、重さの中心は指示書(AGENTS.md、8,699バイト)ではありませんでした。
昔の作業記録を置いた memory フォルダで、日付入りの記録が10ファイル、合計 約45KB(最大の1つが 21,220バイト)ありました。毎回の読み込み約3万字相当という数字とも一致します。
なぜ作業場所の記録が毎回読まれるのか
AI(司令官)は、返事をするたびに、作業場所にある指示書と記録を文脈として読み直します。
文脈は「前回までの経緯を踏まえて答える」ための仕組みです。裏返すと、作業場所に置いたファイルは、置いた分だけ毎回の読み込みに乗り続けます。
記録を溜める場所と、AI(司令官)が毎回読む場所が同じである点が、重さの正体でした。
改善2|古い記録を退避する(消さない)
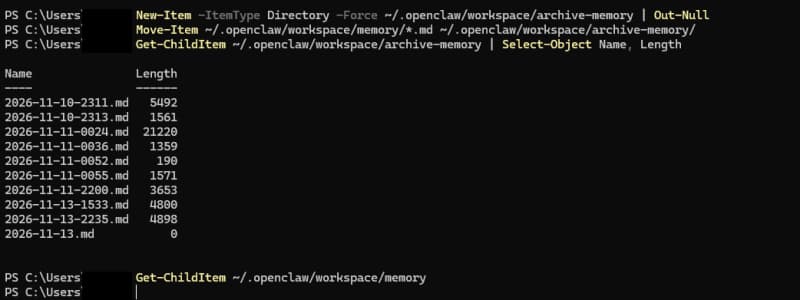
New-Item -ItemType Directory -Force ~/.openclaw/workspace/archive-memory | Out-Null
Move-Item ~/.openclaw/workspace/memory/*.md ~/.openclaw/workspace/archive-memory/
Get-ChildItem ~/.openclaw/workspace/memory古い記録(データ)の移動先を作って移し、元の場所が空になったことを確認します。古いデータはあとで読み返せるように削除はしません。
退避と削除で、退避を選んだ理由
古い記録には、構築の途中で決めた理由や、失敗の経緯が入っています。
削除してしまうと、後で「なぜ今の設定になっているか」を辿れなくなります。
退避なら、司令官の毎回の読み込みからは外れ、必要な時に人間が読み返す分には残ります。「AI(司令官)が読む場所」と「人間が保管する場所」をわける発想です。
控えファイルも読み込みに乗る
手順0の実測では、作業場所のルートにAGENTS.md.bak(6,450バイト)という古い控えも残っていました。
控えは安全のために必要ですが、AI(司令官)の作業場所の中に置いた控えは、記録と同じく読み込みの対象になります。
控えの置き場所は、作業場所の外か、退避用のフォルダに寄せてください。
改善3|指示書を短い「役割カード」に替える
控えを取ってから(AGENTS.md.pre-lightening-2026-11-15.bak)、指示書を短い役割カードに置き換えました。
8,699バイト → 1,194バイトです。実際に使っている役割カードの全文は、次のとおりです。
# 司令官への指示(短い版)

## 役割
- 持ち主の指示を受けて、実働(coder)に渡す。持ち主は判断と最終確認だけをする。
- あいさつ・質問・相談・状況確認には、その場で直接答える。実働に渡すのは「何かを作る・変える」仕事だけ。この切り分けは、他の決まりより優先する。
- 報告は「何の仕事か」を1行で書いてから、結果を書く。

## 守ること
- お金・公開・削除など、取り返しのつかないことは、必ず先に持ち主の許可を取る。
- 仕事は決められた場所(workspace)の中だけでする。外のファイルは、触る前に持ち主に確認する。
- 持ち主の指示がない外部のサービスは使わない。
- 実働への受け渡しは、許可リストの相手(coder)だけ。
- 「できました」という報告は信じず、必ず実際のファイルを見て確かめる。確かめられなければ「未確認」と書く。

## 使い方のコツ
- 持ち主は、やってほしいことを1通にまとめて送る。返事には時間がかかるので、重ねて送らない。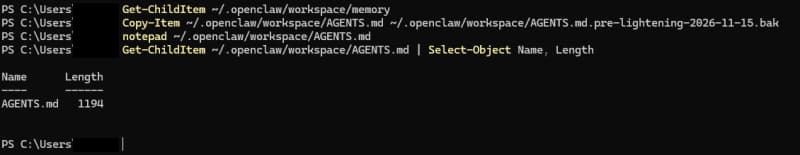
役割カードに残したもの・外したもの
残したものは「今の決まり」だけです。
役割、守ること、使い方のコツの3つに絞りました。
外したものは、過去の経緯、設定の手順、長い説明です。
経緯と手順は、構築記録のファイル(note の各章にあたる記録)に残してあるので、司令官が毎回読む必要はありません。
指示書は「毎回読むもの」なので、指示書に書く内容の基準は「次の返事に必要な決まりかどうか」です。
改善4|再起動して1問だけ試す
- openclaw gateway restart
- Telegramで/new(新しい会話)
- 「なにができる?」を1通だけ送る
1回目(再起動の約1分後)は、「AIサービスに接続できませんでした」で失敗しました。
頭脳本体が動いているか「ollama list」で確認すると正常だったので、再起動直後で接続が間に合わなかっただけと判断し、もう1通送りました。
2回目は、約13分で、AI(司令官)が質問に直接答えました(できることの一覧を日本語で回答してくれました)。司令官が質問に直接答えたのは初めてで、無事にAI(司令官)が機能したことを確認できました。
再起動直後の失敗を、重さの問題と間違えない
再起動の直後は、GatewayとAI(頭脳)の接続が整う前に質問が届き、接続の失敗が返る場面があります。
失敗の文面が「接続できませんでした」の場合は、重さではなく接続のタイミングです。
頭脳本体の起動を「ollama list」で確認し、少し置いてから送り直してください。制限時間の失敗(第7章)とは、直し方が違うので注意しましょう。
改善5|今回のTelegramのテストでわかったこと
今回、Telegramの連携後のテストで、回答が遅い原因は、パソコンのスペックの問題がすべてではなく、読み込ませている「AI(司令官)への指示書(.md)」や読み込ませるデータの重さが影響していることがわかりました。
動くかどうかは設定、速いかどうかはスペック
読み込みを軽くしたら「答えが返ってくる」ようになりました。残る遅さ(約13分)の原因は、大きい頭脳がGPU(速いメモリ)に入りきらないパソコン側です。
読み込みを軽くした上で、GPUのスペックが足らないとわかれば、次に買うパソコンのスペックが見えてきます。
回答の遅さ(重さ)の正体
回答の遅さ(重さ)の正体は、たいてい指示書そのものではなく、知らないうちに溜まった記録の置き場所でした。まず「はかる」ことが大事です。
Telegramを連携したAIを実務に使い始めた記録|2026年11月15日~
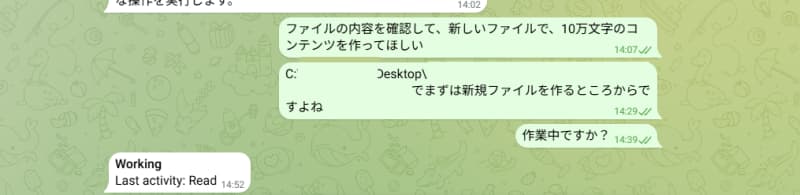
ローカルLLMのAIチームを作り、Telegramのチャット画面から指示を出せるようにした当日から、実際の仕事を渡すテストを開始しました。
テスト1|まず質問で試す
「開いているソフト(動画編集ソフト)を操作できるか」を聞くと、約10分で直接の答えが返ってきました。
今の構成では画面の操作はできず、ファイル操作・コマンド実行・ウェブの取得が仕事の範囲、という正確な答えでした。
質問に直接答えられるので、相談相手としても使えるようになりました。
私の場合、今のパソコンのローカルLLM(AI)ができたことは、ファイルの作成と編集、コマンドの実行、ウェブの内容の取得でした。
できないことは、画面に開いているソフトの操作(ボタンを押す、画面を見て判断してください)。
頼む仕事は「ファイルとコマンドで完結するか」で線を引いてください。線の引き方がわからない場合は、先にAI(司令官)に質問で確認する進め方が安全です。
テスト2|実際の仕事を任せる
私のコンテンツ(文章)の原稿ファイルをもとに、約10万文字のコンテンツを新しく作る仕事を任せてみました。条件は作業前に1通にまとめました。
- 元のファイルは上書きしない。同じ場所に新しいファイルで作ること
- シリーズ作品として出すこと
- 無料部分と有料部分があるので、無料部分から購入への流れ(導線)を作ること
テスト3|「作業中かどうか」の見分け方
長い仕事の途中、頭脳の状態を見るコマンド(ollama ps)の「あと数秒で終了」という表示だけ見ると、止まっているように見えます。
実際は、司令官がファイルを読むなどの道具の実行を待っている間も、ollama ps の表示は進みます。
作業中かどうかは、Telegram側の「Working(作業中)」表示で見るのが確実です。見分けを間違えると、動いている仕事を止めてしまうことになるので、焦らず確認作業をしてください。
テスト4|仕事の任せ方の型
Telegramのチャットで、AI(司令官)に指示を出す際は、2つのポイントを押さえておきましょう。
指示は、場所、条件、禁止事項まで、一通のメッセージで全部まとめてください。メッセージの往復のたびに読み込み直すので、短いやり取りを重ねるほど遅くなります。
TelegramのチャットにAI(司令官)から完了報告が届いたら、成果物は、あなた自身が直接ファイルを確認するようにしてください。
指示の1通に入れる内容
AI(司令官)を通してコーディングAIエージェントに指示を出す際は、次の5点を1通に入れるようにしてください。
- 何を作るか(成果物の名前と形)
- 素材はどこにあるか(ファイルの場所)
- 条件(文字数、形式、シリーズかどうか)
- 禁止事項(元のファイルを上書きしない、など)
- 導線や目的(無料部分から購入への流れを作る、など)
5点が入った指示は、途中で確認の往復が起きにくくなります。チャットで往復するやり取りが減る分、あなた(人間側)の拘束時間も減り、自動化が進みます。
つまずき集|Ollama×OpenClaw×Telegram構築で起きたこと
ローカルLLMのAIチームを作る際に、難しかったことをまとめておきます。
- ollama pull が失敗を繰り返しました
-
原因は、通信が壊れた IPv6 の通り道を優先していたことでした(curl の -4 は成功、-6 は失敗で切りわけ)。
対処方法として、IPv4を優先する設定にして再起動することで解決しました(Windows では Tcpip6 の DisabledComponents に 0x20)。
- 再起動後に「timed out waiting for server to start」
-
原因は、Ollama の更新が途中で重なっていたことでした。
対処方法として、更新が終わるまで待ちました。その後「pull」は正常に通りました。
- ローカルAI(司令官)がAIエージェントの呼び出しを「文章」で返して実行しません
-
原因は、モデルが構造化した道具呼び出しに対応していないことでした(qwen2.5-coder:7b で発生)。
対処方法として、AIエージェントの呼び出しが検証できたモデルに変えることで解決しました。
- 小さいモデル(llama3.1=8B)のAI(司令官)が、短いやり取りではAIエージェントを使えるのに本番の長い文脈では受け渡しができませんでした
-
原因は、「モデルの力不足+文脈の長さ」でした。
対処方法として、AI(司令官)を大きいモデル(qwen2.5:32b)に替えることで、自然な指示で受け渡しができるようになりました。
- 指示したファイルを「作りました」と報告されたのにファイルがないことを繰り返しました
-
原因は、過去にも発生したAI(司令官)の虚偽完了報告です。
対処方法として、AI(司令官)の報告をうのみにせず、自分の目で実際にファイルが作成されているかを確認するようにしました。
- channels add に –token を付けると「does not recognize option」と言われました
-
原因は、2026.11.2 ではその指定方法が使えないことでした(ヘルプの例と実装が一致していません)。
対処方法として、案内形式のopenclaw channels addを使うことで解決しました。
- 合言葉だけがコマンドとして実行されてエラーになりました
-
原因は、貼り付けの順番ミスでした(合言葉を先にコピーしていました)。
対処方法として、入力待ちの画面を先に出し、合言葉のRevoke→Copy→貼り付けの順で運ぶようにしました。
- Telegram の言語一覧に日本語がありませんでした(Android)
-
原因は、この版では一覧に出ないことがあるためでした。
対処方法として、公式の日本語言語パックをリンクから適用することで解決しました。
- ボットが「入力中」のまま返事が来ませんでした
-
原因は、頭脳の制限時間(初期設定300秒)を読み込みが超えたことでした。
対処方法として、手順6の通り、制限時間を延ばすことで解決しました。
- ファイルの中身の表示が文字化けしました(ターミナル)
-
原因は、画面の文字コードの都合でした(ファイル自体は正常です)。
対処方法として、文字ではなくバイト数で照合するようにしました。
- あいさつにも「実働へ渡しました」の報告ばかり返ってきました
-
原因は、AI(司令官)の指示書が受け渡しに寄りすぎていたことでした。
対処方法として、手順3の「司令官との会話と受け渡しの切りわけ」を追記しました。追記で直らなければ、軽量化の記録に進みます。
- 昔に失敗した仕事が、後日いきなり完了しました
-
原因は、AI(司令官)が未完了の仕事を覚えていて、別の指示のついでに拾って実行したことでした(実際に 2026-11-11 のテストが 11-13 に完了しました)。
対処方法として、害はありませんが、完了報告はいつも実際のファイルを目視でで確かめるようにしました。
- 再起動の直後に「AIサービスに接続できませんでした」と返ってきました
-
原因は、再起動直後で、AI(司令官)からモデル(頭脳)への接続が間に合わなかったことでした(頭脳本体は ollama list で正常を確認しました)。
対処方法として、頭脳本体の起動を先に確認し、少し時間を置いてから送り直すようにしました。
- 再起動のあと、接続できないエラーが繰り返し出ました
-
「Couldn’t connect to the AI service」「The background check did not complete」と出て、何度送っても同じでした。
原因は、Ollama のスタートアップがオフになっていて、再起動後に Ollama 自体が起動していなかったことでした(司令官の受け付け=Gatewayは自動起動していたので、警告だけは届く状態でした)。
対処方法として、設定→アプリ→スタートアップで「ollama.exe」をオンにしました。今すぐ使う場合は、スタートから Ollama を開いて起動し、1分待ってから送り直します。
- 頭脳の状態表示で「あと数秒で終了」と出て、止まったように見えました
-
原因は、ollama psの表示が、作業の実行を待っている間も進むことでした(作業の有無とは関係ありません)。
対処方法として、作業中かどうかはTelegram側の「Working」表示で判断するようにしました(実務に使い始めた記録)。
切りわけの型
つまずき集の対処は、全部同じ型で進めています。
- 症状を正確に書く(エラーの文面をそのまま残す)
- 記録(ログ)を見て、詰まっている場所を1つに絞る
- 変える場所は1か所だけにする
- 再起動して、確認する
同時に2か所を変えると、直った時に「どちらの変更が効いたか」がわからなくなります。
わからないまま進めると、次に同じ症状が出た時に、また最初から調べ直しになります。1か所ずつの型を作っていくことは、遠回りに見えて記録が残る分だけ速いです。
新しいパソコンへの移行手順
ローカルLLMでAIチームを作るなら、どうしても最新のデスクトップパソコンが必要になります。新しいパソコンを買った場合の、ローカルLLMの移行方法について解説します。
移行手順1|古いパソコン側のGatewayを止める
先に、古いパソコン側の Gateway を止めます。同じボットを2台のパソコンで受けに行くと取り合いになります。
※理由は下のボットの取り合いとは参照
Telegramのボットは、接続しているパソコンが受け取りに行く形で動きます。
同じボットに2台のパソコンが接続すると、送った文がどちらのパソコンに届くか決まらなくなり、片方で受けた指示をもう片方が知らない状態になります。
移行の順番は「古いパソコンのGatewayを止める→新しい機械で登録する」です。順番を逆にすると、移行の途中で指示が迷子になります。
移行手順2|新しいパソコンでOllamaとOpenClawの土台を設定する
新しいパソコンで手順1〜2(Ollama と OpenClaw の土台)を行います。モデルは ollama pull で取り込み直します。
移行手順3|引き継ぐデータを移す
引き継ぐものを移します。移すのは4つです。
移行するもの1|設定ファイル(~/.openclaw/openclaw.json)
頭脳の割り当てや制限時間など、設定が全部書かれたファイルです。そのまま移しますが、頭脳の割り当てと制限時間だけは、新しい機械に合わせて見直します。
移行するもの2|AI(司令官)の作業場所の中身
AI(司令官)が仕事をするフォルダ一式です。とくに、「AGENTS.md(司令官への指示書=軽量化の記録の役割カード)」は必ず移してください。
移行するもの3|コーディングAIエージェント(実働)の作業場所の中身
コーディングAIエージェント(実働)が仕事をするフォルダ一式です。作りかけのファイルも含めて移します。
移行するもの4|Telegram のボット
作り直す必要はありません。同じボットをそのまま使えます。合言葉はBotFatherの画面からCopyで移します(移す順番は手順5-1参照)
移行手順4|新しいパソコンで登録と確認テストを行う
手順5-2の登録と手順4の確認テストを、新しいパソコンでもう一度、Telegramとパソコンを通信できるように開通させてください。
移行手順5|制限時間を新しいパソコンに合わせて見直す
新しいパソコンがスペックアップしているなら、パソコンの処理能力が高くなり速くなった分、制限時間は様子を見て短く戻してください。
モデルのファイルは引き継ぎません。
新しいパソコンで「ollama pull」を使って取り込み直します。理由は、モデルのファイルが大きく、運ぶ手間の割に取り込み直しと時間の差が小さい点と、取り込み直しのほうが版の食い違いが起きない点です。
引き継ぐ対象は、設定と指示書と作業場所の中身だけです。
運用のルール|ローカルAIチーム構築を終えて残ったもの
ローカルLLMのAIチーム構築を完了し、テストをした結果、残った決まりは6つです。どれも、実際に起きた失敗から生まれました。
ルール1|持ち主の仕事は、判断と最終確認だけ
設定の実行は手順書に落として、迷わない形にします。持ち主が毎回やるのは、やるかどうかを決めることと、終わったかを確認することだけです。
ルール2|設定変更は、順番を崩さない
「控えを取る→1か所だけ変える→再起動→確認」の順で進めます。
「1か所だけ変える」は、ダウンロードの失敗の原因がモデルではなく回線だった経験から生まれました。原因の場所を絞れない変更の仕方をすると、切りわけができなくなります。
ルール3|ローカルだけの作りを崩さない
Ollama を外に公開しません。Gatewayはlocalhostだけにします。
ルール4|外部の入口はTelegramだけ
入口はTelegramだけにし、承認した本人以外は入れません。入口が増えるほど、承認と安全の確認が増え、セキュリティのリスクが大きくなることから決めたルールです。
ルール5|完了の報告は、実際のファイルを確認する
指示を出したAI(司令官)から「作りました」と報告されたのに、ファイルがなかった失敗から生まれました。報告はうのみにせず、自分の目でファイルを確認します。
ルール6|指示は1通にまとめて出す
やり取りの往復のたびに読み込み直すAI(司令官)の仕組みから生まれたルールです。作業中かどうかは、頭脳の状態表示ではなく、入口(Telegram)の作業中表示で確認することをルールにしました。
決まりは増やすものではなく、失敗のたびに1つずつ残していくものです。
ローカルLLMのAIチーム構築の段階では、この「運用のルール」を最初から全部守る必要はありません。止まった時に、つまずき集と、この運用のルールに戻ってください。
ローカルLLMのAIチーム構築記録|2026年11月09日〜11月15日。実機(Windowsノート、GPU4GB/メモリ64GB)での構築・検証・実務投入に基づく。